KI im Unternehmen
KI im Unternehmen
Vom KI-Prototyp in den Betrieb: was zwischen Demo und Produktion fehlt
Florian Rocktäschel · Stand: November 2026 · 12 Minuten Lesezeit
Kurz gesagt
Eine Demo beweist, dass ein Sprachmodell eine Aufgabe grundsätzlich lösen kann. Für den Betrieb fehlt fast immer das System drumherum: ein messbares Ziel, ein Testset, Rechte auf den Daten, feste Modellversionen, Überwachung, eine Kostenrechnung, geklärte Sicherheits- und Rechtsfragen und eine verantwortliche Person. Der Weg in die Produktion führt über drei Stufen (Demo, Pilot, Betrieb), und jede Stufe hat Kriterien, die vor dem nächsten Schritt erfüllt sein müssen. Ein besseres Modell ersetzt keinen dieser Bausteine.
Warum bleiben so viele KI-Prototypen nach der Demo hängen?
Ein Prototyp ist heute in wenigen Tagen gebaut. Ein paar Dokumente, ein Sprachmodell, eine Oberfläche, und die ersten zwanzig Fragen werden beeindruckend beantwortet. Genau diese zwanzig Fragen sind das Problem. Sie stammen meist von den Leuten, die den Prototyp gebaut haben, und sie treffen die Fälle, die funktionieren.
Im Betrieb kommen andere Fragen: unvollständige, mehrdeutige, solche zu Dokumenten, die veraltet sind, und solche, auf die es in den Daten gar keine Antwort gibt. Dazu kommen Nutzer, die nicht alles sehen dürfen, eine Rechnung, die mit der Nutzung wächst, und die Frage, wer haftet, wenn eine falsche Auskunft beim Kunden landet.
Die Marktforschung zeichnet dasselbe Bild. Gartner hat 2024 vorhergesagt, dass mindestens 30 Prozent der Projekte mit generativer KI bis Ende 2025 nach dem Proof of Concept aufgegeben werden, wegen schlechter Datenqualität, fehlender Risikokontrollen, steigender Kosten oder unklarem Nutzen. Das ist eine Prognose, keine Messung. Die Gründe decken sich aber mit dem, was Unternehmen in Deutschland selbst angeben: In der Bitkom-Umfrage vom September 2026 nennen Unternehmen, die KI bereits nutzen, als Hemmnisse vor allem Datenschutzanforderungen (66 Prozent), Rechtsunsicherheit (56 Prozent) und schwer kalkulierbare Kosten (54 Prozent). Ein Viertel beklagt mangelnde Qualität oder fehlende Nachvollziehbarkeit der Ergebnisse.
Keines dieser Hemmnisse ist ein Modellproblem. Es sind Fragen des Systems, und das System entsteht erst nach der Demo. Schon 2015 haben Ingenieure von Google beschrieben, dass der eigentliche Code für maschinelles Lernen nur ein kleiner Teil eines produktiven Systems ist, umgeben von Datenaufbereitung, Konfiguration, Überwachung und Infrastruktur. Für Sprachmodelle gilt das genauso.
Was ist der Unterschied zwischen Demo, Pilot und Betrieb?
Der häufigste Fehler ist, die Demo direkt für alle freizuschalten. Dazwischen gehört ein Pilot mit klaren Regeln. Jede Stufe hat ein anderes Ziel und eine eigene Hürde zum nächsten Schritt:
| Stufe | Wer nutzt es | Ziel | Kriterium für den nächsten Schritt |
|---|---|---|---|
| Demo | das Projektteam | zeigen, dass die Aufgabe lösbar ist | Ziel und Kennzahl sind festgelegt, ein erstes Testset existiert |
| Pilot | eine kleine Gruppe echter Nutzer, echte Daten, echte Rechte | messen, ob es im Alltag trägt | Testset bestanden, Fehlerarten bekannt, Kosten pro Anfrage gemessen, Verantwortliche benannt |
| Betrieb | alle vorgesehenen Nutzer | dauerhaft Nutzen liefern | laufende Messung, Überwachung, geplante Modellwechsel, Budget für Pflege |
Wichtig ist das Kriterium in der letzten Spalte. Es wird vor dem Pilot festgelegt, nicht danach. Sonst wird jeder Pilot zum Erfolg erklärt, weil niemand vorher gesagt hat, was Erfolg heißt. Ebenso wichtig: ein Abbruchkriterium. Ein Pilot, der nach acht Wochen seine Kennzahl nicht erreicht, wird umgebaut oder beendet. Auch das ist ein gutes Ergebnis, weil es Geld spart.
Welche acht Bausteine fehlen zwischen Demo und Betrieb?
| Baustein | Leitfrage | Woran Sie erkennen, dass er steht |
|---|---|---|
| Ziel | Welche Entscheidung oder welcher Ablauf soll besser werden? | eine Kennzahl mit Ausgangswert |
| Messung | Woran erkennen wir, dass die Antworten stimmen? | Testset mit echten Fragen, Ergebnis als Zahl |
| Daten und Rechte | Wer darf was sehen, und wie aktuell sind die Daten? | Rechteprüfung bei jeder Anfrage, Aktualisierung automatisch |
| Versionen | Was passiert, wenn sich das Modell ändert? | feste Modellversion, Wechsel nur nach Test |
| Überwachung | Woran merken wir, dass etwas schiefläuft? | Protokolle, Warnungen, Rückmeldungen der Nutzer |
| Kosten | Was kostet eine Anfrage, und was kostet der Betrieb? | Kosten pro Anfrage gemessen, Obergrenzen gesetzt |
| Sicherheit und Recht | Welche Risiken tragen wir, und wer hat sie akzeptiert? | Bedrohungen geprüft, Datenschutz und AI Act geklärt |
| Verantwortung | Wer kümmert sich, wenn die KI falsch liegt? | benannte Person, Ablauf für Fehler, Zeit für Pflege |
Die folgenden Abschnitte gehen die Bausteine einzeln durch.
Welche Entscheidung soll besser werden?
Wenn ein Unternehmen sagt „Wir wollen das mit KI automatisieren“, lautet meine erste Rückfrage: Welche Entscheidung oder welcher Ablauf soll dadurch besser werden, und woran messen wir das? Ohne Antwort darauf lässt sich weder ein Pilot bewerten noch eine Investition begründen.
Gute Kennzahlen sind konkret und haben einen Ausgangswert: Bearbeitungszeit pro Anfrage im Kundenservice, Anteil der Anfragen, die ohne Rückfrage an die Fachabteilung gelöst werden, Zeit bis zum ersten Angebotsentwurf. „Die Mitarbeitenden sollen produktiver werden“ ist keine Kennzahl. Messen Sie den Ausgangswert vor dem Pilot, sonst fehlt später der Vergleich.
Woran messen Sie, ob die Antworten stimmen?
Das Werkzeug dafür ist ein Testset: einige Dutzend echte Fragen aus dem Alltag, zu denen Fachleute die richtige Antwort und die richtige Quelle kennen. Es wächst mit jedem Fehler, der im Betrieb auffällt. Drei Dinge machen den Unterschied zwischen einem Testset, das etwas aussagt, und einem, das beruhigt:
- Die Suche getrennt prüfen. Bei Assistenten, die auf Firmendokumenten antworten (RAG), zuerst messen, ob die richtige Textstelle überhaupt unter den Treffern ist. Steht sie nicht dort, hilft kein besserer Prompt.
- Fragen ohne Antwort aufnehmen. Ein Teil der Testfragen hat bewusst keine Antwort in den Dokumenten. Gezählt wird, wie oft der Assistent trotzdem etwas erfindet.
- Bestanden oder nicht bestanden. Prüfen Sie pro Kriterium mit Ja oder Nein („Nennt die Antwort die richtige Frist?“) statt mit Schulnoten. Eine Durchschnittsnote von 3,8 lässt sich nicht steuern, „92 von 100 Antworten nennen die richtige Frist“ schon.
Welche Kriterien zählen, ergibt sich nicht aus einer Vorlage. Lesen Sie zu Beginn rund hundert echte Verläufe aus dem Pilot, notieren Sie zu jedem in einem Satz, was schiefging, und fassen Sie die Notizen zu Fehlerarten zusammen. Erst für die häufigsten Fehlerarten lohnt sich eine automatische Prüfung, auch eine, bei der ein Sprachmodell nach festen Kriterien bewertet. Lesen sollte jemand aus dem Fachbereich. Ob eine Auskunft zur Reisekostenregel stimmt, weiß die Buchhaltung besser als die Entwicklung.
Wer darf welche Daten sehen?
In der Demo arbeitet der Prototyp oft mit einem technischen Konto, das alles lesen darf. Im Betrieb ist das der schnellste Weg zu einem Datenschutzvorfall: Der Assistent beantwortet einer Sachbearbeiterin bereitwillig Fragen zu Gehältern, weil das Dokument im Index liegt.
Die Regel ist einfach und die Umsetzung aufwendig: Der Assistent darf nur Textstellen verwenden, die die fragende Person auch selbst öffnen dürfte. Die Rechte müssen bei jeder Anfrage geprüft werden, nicht einmalig beim Einlesen. Dazu kommen zwei Fragen, die in Demos fast nie gestellt werden: Wie schnell kommt ein geändertes Dokument im Index an, und wie schnell verschwindet ein gelöschtes? Wie man Berechtigungen in solchen Systemen sauber baut, beschreibe ich ausführlich in Der Chatbot weiß zu viel: Berechtigungen in RAG-Systemen.
Was passiert, wenn sich das Modell ändert?
Sprachmodelle ändern sich, und Anbieter schalten ältere Versionen nach festen Fristen ab. Wer im Code einen Kurznamen wie „latest“ einträgt, bekommt neue Fassungen ungefragt. Das ist für einen Chat egal und für einen Ablauf, der Antworten maschinell weiterverarbeitet, gefährlich.
Für den Betrieb heißt das:
- eine feste Modellversion eintragen und in jedem Protokoll mitschreiben,
- eine neue Version erst gegen das eigene Testset prüfen und dann bewusst wechseln,
- das Modell hinter einer eigenen Schnittstelle kapseln, damit ein Wechsel des Modells oder des Anbieters eine Konfigurationsänderung ist und kein Umbau.
Der dritte Punkt ist die eigentliche Absicherung gegen Abhängigkeit. Wer Prompts, Testset und Protokolle selbst besitzt, kann zwischen Anbietern wechseln, auch zu europäischen wie Mistral oder zu offenen Modellen auf eigener oder europäischer Infrastruktur. Wie das konkret geht, steht in Modellwechsel ohne Neuanfang: KI-Abhängigkeit vermeiden, und was der Eigenbetrieb verlangt, in Souveräne KI selbst betreiben.
Woran merken Sie im Betrieb, dass etwas schiefläuft?
Klassische Software meldet einen Fehler. Ein Sprachmodell liefert auch im Fehlerfall eine flüssige, plausible Antwort. Deshalb braucht der Betrieb mehr als eine Verfügbarkeitsanzeige:
- Jeder Verlauf wird protokolliert: Frage, gefundene Textstellen, Modellversion, Antwort, Dauer, Tokens. Für das Format gibt es einen offenen, herstellerneutralen Ansatz, die Konventionen für generative KI von OpenTelemetry. Damit landen die Daten in den Werkzeugen, die Ihr Betrieb ohnehin nutzt.
- Nutzer können eine Antwort mit einem Klick als falsch markieren, und jemand liest diese Markierungen wöchentlich.
- Warnungen bei Ausreißern: plötzlich längere Antworten, mehr „weiß ich nicht“, steigende Kosten pro Anfrage, mehr Fehler bei angeschlossenen Systemen.
- Eine Rückfallebene: Fällt der Modellanbieter aus, sieht der Nutzer eine klare Meldung und einen anderen Weg zum Ziel, statt einer Endlosschleife.
Achten Sie bei den Protokollen auf den Datenschutz. Sie enthalten oft personenbezogene Daten und brauchen eine Löschfrist und geregelten Zugriff.
Was kostet der Betrieb wirklich?
Die Kosten im Pilot sagen wenig über die Kosten im Betrieb. Ein Rechenweg mit bewusst angenommenen, runden Preisen (0,50 € pro Million gelesener Tokens, 2,00 € pro Million geschriebener Tokens; die echten Preise stehen auf den Preisseiten der Anbieter und ändern sich):
| Posten | Pilot | Betrieb |
|---|---|---|
| Nutzer × Fragen pro Tag × Arbeitstage | 10 × 5 × 20 | 300 × 8 × 20 |
| Anfragen im Monat | 1.000 | 48.000 |
| Tokens pro Anfrage | 6.500 gelesen, 400 geschrieben | 6.500 gelesen, 400 geschrieben |
| Kosten pro Anfrage | 0,00405 € | 0,00405 € |
| Modellkosten im Monat | etwa 4 € | etwa 194 € |
| mit vier Modellaufrufen pro Frage | etwa 16 € | etwa 778 € |
Die 6.500 gelesenen Tokens setzen sich zusammen aus festen Anweisungen (1.500), sechs gefundenen Textstellen zu je 700 und der Frage samt Verlauf (800). Vier Aufrufe pro Frage sind realistisch, sobald die Anwendung die Frage umformuliert, sucht, antwortet und die Antwort prüft.
Zwei Dinge zeigt die Rechnung. Erstens wächst der Betrieb hier um den Faktor 48 bei der Nutzung und noch einmal um den Faktor 4 durch die Architektur. Zweitens sind die Tokens selten der größte Posten. Liest eine Fachkraft pro Woche hundert Verläufe zu je drei Minuten, sind das rund 20 Stunden im Monat. Bei angenommenen 60 € pro Stunde intern kostet die Qualitätssicherung 1.200 € und damit mehr als das Modell. Dazu kommen Betrieb, Pflege des Index und Weiterentwicklung. Wer die Wirtschaftlichkeit rechnet, rechnet deshalb Zeit von Menschen, nicht nur Tokenpreise. Den vollständigen Rechenweg mit allen Posten zeige ich in Was eine KI-Anwendung im Betrieb kostet.
Setzen Sie trotzdem harte Obergrenzen: maximale Antwortlänge, maximale Aufrufe pro Frage, ein Tagesbudget mit Warnung. Ein Fehler in einer Schleife kostet sonst über Nacht mehr als ein ganzer Monat Pilot.
Welche Sicherheits- und Rechtsfragen müssen geklärt sein?
Die wichtigste Sicherheitsfrage stellt sich, sobald die Anwendung fremde Inhalte liest: eingehende E-Mails, hochgeladene PDFs, Webseiten. In solchen Inhalten können versteckte Anweisungen stehen, und ein Sprachmodell kann sie nicht zuverlässig von echten Anweisungen unterscheiden (Prompt Injection). Die OWASP, eine unabhängige Stiftung für Anwendungssicherheit, führt das auf Platz eins ihrer Risiken für Sprachmodell-Anwendungen und schreibt offen, dass unklar ist, ob es überhaupt einen sicheren Schutz gibt. Gefährlich wird es, wenn drei Fähigkeiten zusammenkommen: Zugriff auf interne Daten, Kontakt mit fremden Inhalten und ein Weg nach draußen, etwa E-Mails versenden. Fehlt eine davon, fehlt auch der Weg, auf dem Daten abfließen. Besonders gilt das für Anwendungen, die selbst handeln dürfen. Dafür gibt es einen eigenen Artikel: KI-Agenten mit Leitplanken.
Rechtlich gehören mindestens diese Punkte auf die Liste, im Zweifel mit Ihrer Datenschutzberatung:
- Datenschutz: Vertrag zur Auftragsverarbeitung mit dem Modellanbieter (Art. 28 DSGVO), Speicherort der Daten, Löschfristen der Protokolle, bei hohem Risiko eine Datenschutz-Folgenabschätzung (Art. 35 DSGVO).
- AI Act, Transparenz: Seit dem 2. August 2026 müssen Anbieter von KI-Systemen, die direkt mit Menschen sprechen, dafür sorgen, dass diese wissen, dass sie mit einer KI interagieren, sofern es nicht offensichtlich ist (Art. 50). Wer einen Assistenten selbst baut und Kunden anbietet, ist in der Regel selbst Anbieter.
- AI Act, Hochrisiko: Wird KI etwa bei der Personalauswahl eingesetzt, gelten nach der Verschiebung durch den Digital Omnibus ab dem 2. Dezember 2027 deutlich strengere Pflichten. Wer heute so etwas baut, sollte diese Pflichten schon in der Architektur vorsehen.
Wer ist verantwortlich, wenn die KI falsch liegt?
Ein Prototyp gehört dem Team, das ihn gebaut hat. Eine Anwendung im Betrieb braucht eine Person, die für das Ergebnis einsteht: Sie entscheidet über Modellwechsel, liest die Fehlerberichte, priorisiert Verbesserungen und darf die Anwendung abschalten. Diese Person sitzt am besten im Fachbereich, mit Rückendeckung aus der Technik.
Dazu gehört ein Ablauf für Fehler. Wenn eine Mitarbeiterin eine falsche Antwort meldet: Wer schaut sich das an, bis wann, und wie kommt der Fall ins Testset? KI ist kein Projekt mit Enddatum. Sie bleibt ein dauerhafter Begleiter, der Pflege braucht, und das gehört von Anfang an ins Budget.
Welche Fehlerbilder sind typisch, und wo liegt die Ursache?
| Symptom | Häufige Ursache | Baustein |
|---|---|---|
| „Die KI ist halt manchmal ungenau“ | Suche findet die richtige Stelle nicht, niemand misst es | Messung |
| Erfundene Antworten auf Fragen ohne Antwort | kein Ausweg erlaubt, keine Testfragen dazu | Messung |
| Mitarbeitende sehen Inhalte, die sie nicht sehen dürften | technisches Konto mit vollen Rechten | Daten und Rechte |
| Plötzlich anderes Antwortformat, nachgelagerter Schritt bricht | Modell-Alias statt fester Version | Versionen |
| Rechnung doppelt so hoch wie geplant | längere Antworten, mehr Aufrufe pro Frage, keine Obergrenze | Kosten |
| Nach drei Monaten nutzt es kaum noch jemand | keine Kennzahl, niemand verantwortlich, Fehler werden nicht behoben | Ziel, Verantwortung |
Aus der Praxis
Ein Prototyp muss zwei Dinge beweisen: dass die Technik trägt und dass der Prozess funktioniert. Das Zweite wird gern vergessen. Lässt sich der Ablauf überhaupt abbilden, machen die Leute mit, stimmt das Ergebnis? Bei KI entscheidet sich das früh. Nachbessern kann man immer, aber manchmal wird schon früh klar, dass ein Ansatz nicht funktioniert oder eine andere Herangehensweise braucht. Das jetzt zu sehen ist billiger als nach dem Rollout.
Bei Kivvo, der KI-Plattform, deren Produktentwicklung ich für einen Kunden verantworte, gibt es deshalb nicht den einen Prototyp. Die Plattform ist die Grundlage, darauf bauen einzelne Module auf, und jedes Modul hat eine eigene Frage, die ein Prototyp beantworten muss: geringe Latenz bei der Sprache, die Qualität der Dokumente, wie schnell Dokumente verarbeitet werden, wie die Plattform skaliert.
Und: so früh wie möglich mit echten Daten testen. Sonst lügt man sich gern selbst etwas vor. Ein verbreiteter Fehler ist, mit Testdaten zu prüfen, die eine KI erzeugt hat. Die sind meist schon so formuliert, dass eine KI sie gut verwerten kann. Echte Dokumente und echte Fragen sind unordentlicher, und genau daran scheitert ein Prototyp später im Betrieb.
Prüfliste: Ist Ihr Prototyp bereit für den Betrieb?
Beantworten Sie jede Frage mit Ja oder Nein. Jedes Nein ist eine Aufgabe vor dem nächsten Schritt.
- Gibt es eine Kennzahl mit Ausgangswert und ein vorab festgelegtes Erfolgs- und Abbruchkriterium?
- Gibt es ein Testset mit echten Fragen, auch solchen ohne Antwort in den Daten?
- Wird die Suche getrennt von den Antworten gemessen?
- Sieht jede Person nur Inhalte, die sie auch selbst öffnen dürfte, geprüft bei jeder Anfrage?
- Ist geregelt, wie schnell geänderte und gelöschte Dokumente im Index ankommen?
- Ist eine feste Modellversion eingetragen, und gibt es einen Ablauf für den Wechsel?
- Lässt sich das Modell wechseln, ohne die Anwendung umzubauen?
- Wird jeder Verlauf protokolliert, mit Löschfrist und geregeltem Zugriff?
- Können Nutzer falsche Antworten melden, und liest jemand diese Meldungen?
- Sind die Kosten pro Anfrage gemessen und Obergrenzen gesetzt?
- Ist geprüft, ob die Anwendung fremde Inhalte liest, interne Daten sieht und nach draußen kommunizieren kann?
- Sind Auftragsverarbeitung, Speicherort und Transparenzpflicht geklärt?
- Gibt es eine verantwortliche Person mit Zeit und Budget für die Pflege?
Was muss die Geschäftsführung entscheiden?
Vier Entscheidungen kann niemand aus der Technik abnehmen: welches Ziel gilt und wann der Pilot abgebrochen wird, welches Restrisiko das Unternehmen bewusst trägt, wer die Verantwortung bekommt, und welches laufende Budget die Anwendung nach dem Start erhält. Sind diese vier Punkte entschieden, ist der Rest Handwerk. Sind sie offen, bleibt auch der beste Prototyp eine Vorführung.
Mehr dazu, wie ich Unternehmen auf diesem Weg begleite, steht auf der Seite KI im Unternehmen. Offenlegung: Ich verdiene an keinem der hier genannten Anbieter oder Werkzeuge. Ich verantworte für einen Kunden die Produktentwicklung von Kivvo, einer in Deutschland betriebenen KI-Plattform.
Häufige Fragen
Das hängt weniger vom Modell ab als von den Daten und den Rechten. Ein Assistent auf wenigen, gut gepflegten Dokumenten mit einfachen Zugriffsregeln ist schneller im Betrieb als einer, der an mehrere Systeme mit eigenen Berechtigungen angebunden wird. Planen Sie den Pilot mit festem Zeitraum und vorab festgelegtem Erfolgskriterium, dann wissen Sie am Ende, ob und wie es weitergeht.
Selten. Wenn die Suche die richtige Textstelle nicht findet, die Rechte fehlen oder niemand misst, ändert ein besseres Modell daran nichts. Ein Modellwechsel lohnt sich erst, wenn das Testset zeigt, dass das Modell selbst der Engpass ist.
Zum Start reichen einige Dutzend echte Fragen, die Fachleute beantworten können, darunter einige ohne Antwort in den Daten. Wichtiger als die Größe ist, dass das Testset mit jedem Fehler aus dem Betrieb wächst und bei jeder Änderung erneut läuft.
Nicht für den ersten Anwendungsfall. Sobald mehrere Anwendungen entstehen, lohnt sich aber eine gemeinsame Grundlage für Rechte, Protokolle, Modellzugang und Kostenkontrolle. Sonst baut jedes Team diese Bausteine neu, und jedes etwas anders.
Die Transparenzpflicht nach Art. 50 betrifft KI-Systeme, die direkt mit Menschen interagieren, und gilt seit dem 2. August 2026. Strengere Pflichten gelten für Hochrisikobereiche wie die Personalauswahl, nach der Verschiebung ab dem 2. Dezember 2027. Ob und wie Ihr Anwendungsfall betroffen ist, sollten Sie im Zweifel rechtlich prüfen lassen.
Quellen
Stand: November 2026. Rechtliche Angaben ohne Gewähr, keine Rechtsberatung. Preise im Rechenweg sind Annahmen.
- Bitkom, KI-Nutzung und Hemmnisse in deutschen Unternehmen, September 2026: bitkom.org
- Gartner, Prognose zu abgebrochenen GenAI-Projekten, Juli 2024: gartner.com
- Sculley et al., Hidden Technical Debt in Machine Learning Systems, NeurIPS 2015: papers.nips.cc
- Hamel Husain, Shreya Shankar, AI Evals FAQ: hamel.dev
- OWASP, Top 10 for LLM Applications 2025, LLM01 Prompt Injection: genai.owasp.org
- Simon Willison, The lethal trifecta for AI agents, Juni 2025: simonwillison.net
- OpenTelemetry, Semantic Conventions für generative KI: github.com/open-telemetry
- Mistral, Model lifecycle policy: docs.mistral.ai
- AI Act, Art. 50: artificialintelligenceact.eu; Digital Omnibus, VO (EU) 2026/1744: regulation-ai.eu
Über den Autor
Ich bin Florian Rocktäschel, Ingenieur (RWTH Aachen). Ich arbeite seit 2013 mit lernenden Verfahren und seit 2018 als Fractional CTO für mittelständische Unternehmen. Hier schreibe ich auf, was ich in dieser Arbeit immer wieder gefragt werde.
Wo steht Ihre Technik?
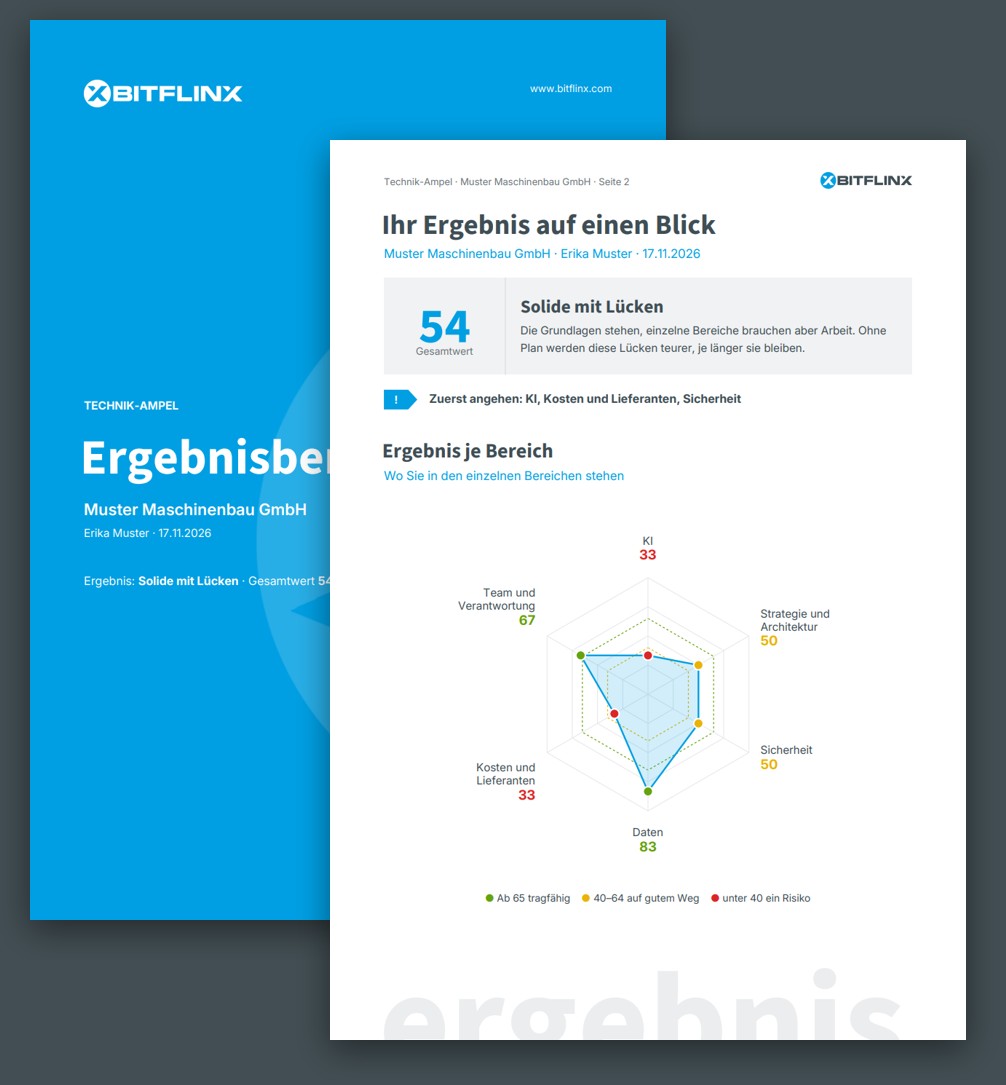
Die Technik-Ampel fragt in 15 Fragen nach KI, Strategie, Sicherheit, Daten, Kosten und Team. Zehn Minuten, Ergebnis sofort, kostenlos.