

KI im Unternehmen
KI-Agenten mit Leitplanken: Architektur für Agenten, die handeln dürfen
Florian Rocktäschel · Stand: November 2026 · 12 Minuten Lesezeit
Kurz gesagt
Ein KI-Agent wird nicht durch einen guten Prompt sicher. Sicher wird er durch Grenzen, die außerhalb des Sprachmodells durchgesetzt werden: wenige, eng geschnittene Werkzeuge, die mit den Rechten des Nutzers arbeiten, feste Aktionsklassen mit Freigabe durch einen Menschen, Limits für Schritte und Kosten, Werkzeuge, die doppelte Aufrufe verkraften, ein vollständiges Protokoll und ein Notaus. Vor all dem steht eine nüchterne Frage: Braucht der Prozess überhaupt einen Agenten, oder reicht ein fester Ablauf mit einem KI-Schritt darin?
Was unterscheidet einen KI-Agenten von einem Chatbot oder einem Workflow?
Ein Chatbot antwortet. Ein Agent handelt: Er ruft Systeme auf, legt Vorgänge an, verschickt Nachrichten, und er entscheidet selbst, welcher Schritt als Nächstes kommt. Anthropic unterscheidet in einem viel zitierten Leitfaden zwei Bauformen. In Workflows folgen Sprachmodell und Werkzeuge einem fest programmierten Ablauf. In Agenten steuert das Modell den Ablauf und die Werkzeugwahl selbst.
| Bauform | Wer bestimmt den Ablauf | Geeignet für | Risiko |
|---|---|---|---|
| fester Ablauf ohne KI | der Code | klar geregelte Vorgänge | gering, gut testbar |
| fester Ablauf mit KI-Schritt | der Code, die KI erledigt einen Teil (etwa Einordnen, Zusammenfassen) | die meisten Anwendungsfälle im Mittelstand | überschaubar, der Ablauf bleibt vorhersehbar |
| Agent | das Sprachmodell | offene Aufgaben mit wechselnden Wegen | hoch, jeder Lauf kann anders verlaufen |
Derselbe Leitfaden rät, die einfachste Lösung zu suchen und Komplexität nur dann hinzuzufügen, wenn sie nötig ist. Agenten bringen höhere Kosten und Fehler, die sich fortpflanzen.
Braucht Ihr Prozess überhaupt einen Agenten?
Agenten sind eines der großen Themen dieses Winters. Laut Bitkom setzen 11 Prozent der Unternehmen, die KI nutzen oder planen, bereits Agenten ein, weitere 29 Prozent planen es. Gartner sagt gleichzeitig voraus, dass über 40 Prozent der Agentenprojekte bis Ende 2027 eingestellt werden, wegen steigender Kosten, unklaren Nutzens und unzureichender Risikokontrollen. Nach Gartners Schätzung bieten von Tausenden Anbietern nur rund 130 tatsächlich agentische Technik an; der Rest hat Chatbots und Automatisierung umbenannt.
Was ich dabei häufig sehe, sind aufgeblasene Agentensysteme, die größer und träger sind als der Prozess, den sie ersetzen sollen. Ein Agent lohnt sich, wenn drei Bedingungen zusammenkommen:
- Der Weg zum Ziel ist von Fall zu Fall verschieden und lässt sich nicht sinnvoll vorab festlegen.
- Ein Fehler lässt sich erkennen und korrigieren, bevor er Schaden anrichtet.
- Der Nutzen pro Fall rechtfertigt mehrere Modellaufrufe und die Pflege des Systems.
Fehlt eine davon, ist ein fester Ablauf mit einem KI-Schritt fast immer die bessere Wahl. Er ist billiger, schneller und lässt sich testen wie jede andere Software.
Warum wird ein Agent mit jedem Schritt unzuverlässiger?
Eine vereinfachte Rechnung zeigt das Grundproblem. Angenommen, jeder einzelne Schritt eines Agenten gelingt mit 95 Prozent Wahrscheinlichkeit, und die Schritte sind voneinander unabhängig:
| Schritte pro Aufgabe | Zuverlässigkeit je Schritt 95 % | Zuverlässigkeit je Schritt 99 % |
|---|---|---|
| 1 | 95 % | 99 % |
| 5 | 77 % | 95 % |
| 10 | 60 % | 90 % |
| 20 | 36 % | 82 % |
In der Praxis sind Schritte nicht unabhängig, und gute Agenten korrigieren manche Fehler selbst. Die Richtung stimmt trotzdem: Jeder zusätzliche Schritt ist eine weitere Gelegenheit, falsch abzubiegen. Daraus folgt die wichtigste Entwurfsregel: Ein guter Agent ist klein und überprüfbar. Er erledigt eine Aufgabe zuverlässig statt zehn Aufgaben ungefähr. Wo mehrere Aufgaben anstehen, sind mehrere kleine Agenten oder feste Abläufe mit klaren Übergabepunkten besser als ein großer.
Warum ist der Prompt keine Sicherheitsgrenze?
„Du darfst niemals Kundendaten weitergeben“ im Systemprompt ist ein Wunsch, keine Regel. Sprachmodelle befolgen Anweisungen mit hoher Wahrscheinlichkeit, aber nicht mit Gewissheit. Und sie können Anweisungen aus fremden Inhalten nicht zuverlässig von Ihren eigenen unterscheiden. Steht in einer eingehenden Mail oder einem PDF eine versteckte Anweisung, kann der Agent ihr folgen (Prompt Injection).
Die OWASP, eine unabhängige Stiftung für Anwendungssicherheit, schreibt dazu offen, es sei unklar, ob es überhaupt einen sicheren Schutz gegen Prompt Injection gibt. Filterprodukte werben gern damit, 95 Prozent der Angriffe zu erkennen. Der Entwickler Simon Willison hält dagegen, dass 95 Prozent in der Anwendungssicherheit eine ungenügende Note sind: Ein Angreifer probiert so lange, bis er in den übrigen fünf Prozent landet.
Daraus folgt der Grundsatz dieses Artikels: Alles, was ein Agent auf keinen Fall tun darf, muss außerhalb des Modells verhindert werden, im Code, in den Rechten, in der Infrastruktur. Der Prompt beschreibt die Aufgabe. Die Architektur setzt die Grenzen.
Wie sieht eine Architektur mit Leitplanken aus?
Das Sprachmodell schlägt Aktionen vor. Ausgeführt wird nur, was eine eigene Kontrollschicht prüft und zulässt. Ein Aufbau aus sieben Teilen trennt Vorschlag und Ausführung sauber:
| Teil | Aufgabe | Wichtigste Regel |
|---|---|---|
| Modell | plant den nächsten Schritt, wählt ein Werkzeug | hat selbst keinen direkten Zugriff auf Systeme |
| Werkzeugschicht | prüft jeden Aufruf: erlaubtes Werkzeug, gültige Parameter, Rechte des Nutzers | jeder Aufruf geht hier durch, ohne Ausnahme |
| Freigabe | legt Aktionen mit Außenwirkung einem Menschen vor | zeigt die konkrete Aktion, nicht „Fortfahren?“ |
| Ausführung | führt den Aufruf aus, mit Schlüssel gegen Doppelungen | doppelter Aufruf wirkt wie einer |
| Limits | begrenzt Schritte, Zeit, Kosten und Aufrufe pro Minute | wird im Code erzwungen, nicht im Prompt |
| Protokoll | schreibt jeden Schritt mit: Eingabe, Werkzeug, Parameter, Ergebnis, Modellversion | lückenlos und für Fachleute lesbar |
| Notaus | stoppt einen Lauf, ein Werkzeug oder den ganzen Agenten | jederzeit, ohne Deployment |
Die OWASP nennt das Prinzip hinter der Werkzeugschicht „Complete Mediation“: Die Prüfung findet in den angeschlossenen Systemen statt, nicht im Vertrauen darauf, dass das Modell sich an Regeln hält.
Welche Werkzeuge und Rechte bekommt der Agent?
Die OWASP beschreibt unter dem Stichwort „Excessive Agency“ drei Ursachen für Schäden durch Agenten: zu viele Funktionen, zu viele Rechte und zu viel Selbstständigkeit. Die Gegenmittel sind konkret:
- Eng geschnittene Werkzeuge. Statt „SQL ausführen“ ein Werkzeug „offene Rechnungen eines Kunden lesen“. Statt „E-Mail senden“ ein Werkzeug „Antwortentwurf im Postfach ablegen“. Je enger das Werkzeug, desto kleiner der mögliche Schaden.
- Keine offenen Werkzeuge. Shell-Zugriff, beliebige URLs aufrufen oder freie Datenbankabfragen gehören nicht in einen Agenten im Betrieb.
- Rechte des Nutzers statt eines Superkontos. Der Agent handelt mit den Berechtigungen der Person, für die er arbeitet. Was sie nicht darf, darf er auch nicht. Wie das bei Assistenten auf Firmendokumenten aussieht, beschreibe ich in Der Chatbot weiß zu viel: Berechtigungen in RAG-Systemen.
- Parameter prüfen. Beträge, Empfänger, Datumsangaben und Kennungen werden gegen feste Regeln validiert, bevor etwas passiert.
Gute Werkzeuge liefern außerdem Fehlermeldungen, mit denen das Modell etwas anfangen kann: was falsch war, wie es richtig geht, was als Nächstes sinnvoll ist. Ein nacktes „Error 400“ führt zu Wiederholungsschleifen, die Zeit und Geld kosten.
Welche Aktionen darf der Agent allein, welche nur mit Freigabe?
Ordnen Sie jedes Werkzeug vor dem Start einer Aktionsklasse zu. Die Klasse bestimmt, wie viel Selbstständigkeit der Agent bekommt:
| Klasse | Beispiele | Regel |
|---|---|---|
| A: lesen | Kundendaten nachschlagen, Lagerbestand abfragen, Dokumente durchsuchen | darf der Agent allein, im Rahmen der Nutzerrechte |
| B: intern vorbereiten, umkehrbar | Entwurf anlegen, Ticket kommentieren, Termin vormerken | darf der Agent allein, wird protokolliert und ist rückgängig zu machen |
| C: Wirkung nach außen oder schwer umkehrbar | Mail an Kunden senden, Bestellung auslösen, Stammdaten ändern | nur nach Freigabe durch einen Menschen |
| D: nicht umkehrbar oder hohes Risiko | Zahlung ausführen, Daten löschen, Verträge kündigen | gar nicht durch den Agenten, nur durch Menschen im Fachsystem |
Die Grenze zwischen B und C ist die wichtigste Entscheidung im ganzen Projekt, und sie gehört der Fachabteilung und der Geschäftsführung, nicht der Entwicklung. Rechtlich gibt es eine zusätzliche Linie: Nach Art. 22 DSGVO haben Menschen das Recht, keiner ausschließlich automatisierten Entscheidung unterworfen zu werden, die ihnen gegenüber rechtliche Wirkung entfaltet oder sie ähnlich erheblich beeinträchtigt. Agenten, die über Anträge, Bewerbungen oder Kredite mitentscheiden, gehören deshalb in Klasse C oder D, im Zweifel nach rechtlicher Prüfung.
Wie baut man eine Freigabe, die nicht zum Abnicken wird?
Eine Freigabe, die hundertmal am Tag „Fortfahren? Ja/Nein“ fragt, wird nach einer Woche blind bestätigt. Dann ist sie Dekoration. Gute Freigaben haben vier Eigenschaften:
- Sie zeigen die konkrete Aktion: Empfänger, Betrag, den fertigen Text, bei Änderungen den Vorher-nachher-Vergleich.
- Sie zeigen, worauf der Agent sich stützt: die Quelle, die Kundenhistorie, die Regel.
- Sie erlauben Korrigieren, nicht nur Ablehnen. Der Mensch ändert den Entwurf und gibt ihn frei.
- Sie werden gemessen. Wie viele Vorschläge gehen unverändert durch, wie viele werden korrigiert, wie viele abgelehnt? Wird fast alles unverändert freigegeben, prüfen Sie, ob die Klasse herabgestuft werden kann. Wird viel korrigiert, ist der Agent für diese Aufgabe noch nicht reif.
Der AI Act beschreibt für Hochrisiko-Systeme in Art. 14, was menschliche Aufsicht leisten muss: die Grenzen des Systems verstehen, sich der Neigung bewusst sein, maschinellen Vorschlägen zu sehr zu vertrauen, Ergebnisse übersteuern und das System sicher anhalten können. Auch für Agenten außerhalb der Hochrisikobereiche ist das eine gute Vorlage.
Wie schützen Sie einen Agenten vor Prompt Injection?
Die erste Frage lautet: Welche dieser drei Fähigkeiten hat der Agent? Zugriff auf interne Daten, Kontakt mit fremden Inhalten, einen Weg nach draußen. Simon Willison nennt die Kombination aller drei die „Lethal Trifecta“. Fehlt eine, fehlt der Weg, auf dem Daten abfließen können. In der Praxis heißt das meist: Ein Agent, der fremde Inhalte liest, schickt nichts selbst nach draußen. Er bereitet vor, ein Mensch gibt frei.
Wo das nicht reicht, helfen Entwurfsmuster, die Forschende von ETH Zürich, IBM, Google, Microsoft und anderen 2025 zusammengetragen haben. Ihr Grundsatz: Hat ein Agent fremde Inhalte aufgenommen, muss er danach eingeschränkt sein. Vier der Muster sind im Unternehmensalltag gut umsetzbar:
- Erst planen, dann ausführen. Der Agent legt die Schritte fest, bevor er fremde Inhalte liest. Was in einer Mail steht, kann den Plan nicht mehr ändern.
- Auswahl statt freier Aktion. Der Agent wählt nur aus einer festen Liste von Aktionen und sieht deren Ergebnisse nicht. Er funktioniert wie eine intelligente Weiche.
- Zwei Modelle mit getrennten Rollen. Ein Modell ohne Werkzeuge liest die fremden Inhalte und liefert nur strukturierte Werte zurück, etwa „Rechnung, Betrag, Fälligkeit“. Das Modell mit Werkzeugen sieht den Originaltext nie.
- Kontext klein halten. Was für den nächsten Schritt nicht nötig ist, fliegt aus dem Kontext, auch die ursprüngliche Anfrage, wenn sie erledigt ist.
Eine eigene Angriffsfläche sind die Werkzeuge selbst. Viele Agenten binden Werkzeuge heute über das Model Context Protocol (MCP) an, einen offenen Standard, der inzwischen unter dem Dach der Linux Foundation weiterentwickelt wird. Sicherheitsforscher von Invariant Labs haben 2025 gezeigt, dass in Werkzeugbeschreibungen versteckte Anweisungen stehen können, die der Nutzer nicht sieht, das Modell aber befolgt, und dass sich Beschreibungen nach der Freigabe ändern lassen. Binden Sie deshalb nur geprüfte MCP-Server an, schreiben Sie ihre Versionen fest und prüfen Sie Änderungen an Werkzeugbeschreibungen wie Änderungen am Code.
Welche Limits braucht jeder Agent?
Ein Agent ohne Limits kann in eine Schleife geraten, und dann wird es teuer. Der Grund: Mit jedem Schritt wächst der Kontext, den das Modell erneut lesen muss. Die Kosten steigen deshalb nicht linear, sondern mit dem Quadrat der Schritte. Eine Rechnung mit bewusst angenommenen Preisen (0,50 € pro Million gelesener Tokens, 2,00 € pro Million geschriebener) und einem Kontext, der pro Schritt um 1.500 Tokens wächst:
| Lauf | Schritte | gelesene Tokens | Kosten pro Lauf | bei 500 Läufen am Tag |
|---|---|---|---|---|
| mit Limit | 25 | etwa 0,56 Millionen | etwa 0,30 € | etwa 150 € |
| Schleife ohne Limit | 200 | etwa 30,8 Millionen | etwa 15,50 € | etwa 7.750 € |
Achtmal so viele Schritte kosten hier rund fünfzigmal so viel. Jeder Agent braucht deshalb harte Grenzen, durchgesetzt im Code:
- höchstens eine feste Zahl an Schritten pro Lauf,
- eine maximale Laufzeit,
- ein Kostenbudget pro Lauf und pro Tag, mit Abbruch und Warnung,
- eine Obergrenze für Aufrufe je Werkzeug und Minute, damit ein fehlerhafter Agent kein angeschlossenes System lahmlegt.
Ein Abbruch durch ein Limit ist kein Fehler. Der Lauf endet mit einem sauberen Zwischenstand und einer Meldung an einen Menschen.
Was passiert, wenn ein Schritt fehlschlägt?
Agenten wiederholen Aufrufe: wegen eines Zeitlimits, weil das Modell unsicher ist, ob der erste Versuch geklappt hat, oder weil ein Lauf nach einem Fehler neu startet. Jedes schreibende Werkzeug muss das verkraften. Das Verfahren heißt Idempotenz: Jede Aktion bekommt einen eindeutigen Schlüssel, etwa „Rechnung zu Auftrag 4711“, und ein zweiter Aufruf mit demselben Schlüssel liefert das gespeicherte Ergebnis, statt erneut zu buchen. Zahlungsdienste arbeiten seit Jahren so.
Für Abläufe über mehrere Systeme gehört zusätzlich festgelegt, wie ein halb fertiger Lauf aufgeräumt wird: Welche Schritte werden zurückgenommen, welche bleiben stehen, und wer bekommt die Meldung? Speichern Sie den Zustand eines Laufs außerhalb des Modells, damit er nach einem Abbruch nachvollziehbar fortgesetzt oder beendet werden kann.
Woran erkennen Sie, dass ein Agent abgeschaltet werden muss?
Legen Sie das vor dem Start fest, nicht im Ernstfall. Typische Auslöser für den Notaus:
- Ein Agent versucht ein Werkzeug außerhalb seiner Liste oder mit Parametern außerhalb der Regeln aufzurufen.
- Die Ablehnungsquote bei Freigaben steigt deutlich.
- Kosten, Schritte oder Fehler je Lauf weichen stark vom Normalwert ab.
- Ein angeschlossenes System meldet ungewöhnlich viele Zugriffe.
- Eine neue Modellversion oder ein geänderter MCP-Server ist ungeprüft in Betrieb gegangen.
Der Notaus muss auf drei Ebenen funktionieren: einen einzelnen Lauf stoppen, ein einzelnes Werkzeug sperren, den ganzen Agenten abschalten. Er muss ohne neues Deployment wirken, und eine benannte Person muss ihn auslösen dürfen. Das Protokoll zeigt danach, was passiert ist.
Ein Agent ist eine Anwendung im Betrieb wie jede andere. Testset, Überwachung, feste Modellversionen und Kostenrechnung gelten für ihn genauso. Was zwischen Demo und Produktion allgemein fehlt, beschreibe ich in Vom KI-Prototyp in den Betrieb.
Aus der Praxis
Meine Regel für Agenten: Am Anfang dürfen sie nichts. Rechte kommen Stück für Stück dazu, jedes einzeln begründet. Das ist die professionelle Herangehensweise, und sie erspart die Katastrophe später. Der umgekehrte Weg, erst alles erlauben und dann einschränken, findet die Lücke erst, wenn sie schon genutzt wurde.
Im Betrieb heißt das: Der Agent wird überwacht. Versucht er, auf Daten zuzugreifen, die er für seine Aufgabe nicht braucht, wird das sichtbar, und jemand fragt nach, warum. Die Rechte selbst liegen nicht in der KI. Davor steht ein Rechtesystem, das mit der KI nichts zu tun hat: das rollenbasierte Rechtesystem der Software. Der Agent arbeitet über dieselben Schnittstellen wie jeder andere Nutzer und kann sie nicht umgehen. Eine KI ist nicht in der Lage, Rechte zuverlässig einzuhalten. Das muss die Software erledigen.
Prüfliste: Ist Ihr Agent bereit für den Start?
Vier Fragen müssen vor dem Start beantwortet sein. Jede hat Unterpunkte, die sich mit Ja oder Nein prüfen lassen.
Was darf der Agent und was ausdrücklich nicht?
- Ist geprüft, dass ein fester Ablauf mit KI-Schritt nicht ausreicht?
- Hat der Agent eine einzige, klar beschriebene Aufgabe?
- Ist jedes Werkzeug einer Aktionsklasse zugeordnet, und ist Klasse D ausgeschlossen?
Auf welche Systeme und Daten greift er zu?
- Arbeitet der Agent mit den Rechten des Nutzers statt mit einem Superkonto?
- Sind die Werkzeuge eng geschnitten, ohne Shell, freie Abfragen oder beliebige URLs?
- Ist geprüft, ob er interne Daten sieht, fremde Inhalte liest und nach draußen kommunizieren kann, und fehlt mindestens eine dieser Fähigkeiten?
- Sind angebundene MCP-Server geprüft und ihre Versionen festgeschrieben?
Wann muss ein Mensch freigeben?
- Zeigt die Freigabe die konkrete Aktion und ihre Grundlage?
- Kann der Mensch korrigieren, nicht nur ablehnen?
- Wird die Freigabequote gemessen?
Woran erkennen Sie, dass er abgeschaltet werden muss?
- Sind Schritte, Laufzeit, Kosten und Aufrufe pro Minute im Code begrenzt?
- Sind alle schreibenden Werkzeuge idempotent?
- Wird jeder Schritt protokolliert, mit Modellversion?
- Sind Auslöser für den Notaus festgelegt, und wer darf ihn auf welcher Ebene auslösen?
Mehr dazu, wie ich Unternehmen bei KI im Betrieb begleite, steht auf der Seite KI im Unternehmen. Offenlegung: Ich verdiene an keinem der hier genannten Anbieter oder Werkzeuge. Ich verantworte für einen Kunden die Produktentwicklung von Kivvo, einer in Deutschland betriebenen KI-Plattform.
Häufige Fragen
Bei einer Automatisierung legt der Code den Ablauf fest, auch wenn ein Schritt darin von einer KI erledigt wird. Bei einem Agenten entscheidet das Sprachmodell selbst, welcher Schritt als Nächstes kommt und welches Werkzeug es nutzt. Das macht Agenten flexibler und schwerer vorherzusagen.
Nicht zwingend. Die Schleife aus Modellaufruf und Werkzeugaufruf ist schnell selbst gebaut, und die Leitplanken gehören ohnehin in Ihren eigenen Code. Ein Framework spart Arbeit bei Anbindung und Protokollierung. Eine europäische Open-Source-Option ist Haystack von deepset aus Berlin (Apache-2.0-Lizenz), das eine Agenten-Komponente und eine MCP-Anbindung mitbringt.
Nach heutigem Stand nicht zuverlässig, auch nicht mit Filtern. Deshalb gehört die Absicherung in die Architektur: Einem Agenten, der fremde Inhalte liest, fehlt der direkte Weg nach draußen, und Aktionen mit Außenwirkung brauchen eine Freigabe.
Er sollte mit Ihren Rechten arbeiten, aber über eine eigene, nachvollziehbare Kennung, damit im Protokoll erkennbar ist, was der Agent getan hat und was Sie selbst. Ein gemeinsames Superkonto für alle Agenten ist der häufigste Konstruktionsfehler.
Ein Mensch, der weiß, wo die typischen Lücken liegen, bevor echte Daten in die Anwendung kommen. Worauf es dabei ankommt, beschreibe ich in Vibe-coded App vor dem Livegang: die Prüfung in zehn Schritten.
Quellen
Stand: November 2026. Rechtliche Angaben ohne Gewähr, keine Rechtsberatung. Preise im Rechenweg sind Annahmen.
- Bitkom, KI und KI-Agenten in deutschen Unternehmen, September 2026: bitkom.org
- Gartner, Prognose zu Agentenprojekten, Juni 2025: gartner.com
- Anthropic, Building effective agents, Dezember 2024: anthropic.com
- OWASP, Top 10 for LLM Applications 2025, LLM06 Excessive Agency: genai.owasp.org; LLM01 Prompt Injection: genai.owasp.org
- Simon Willison, The lethal trifecta for AI agents, Juni 2025: simonwillison.net
- Beurer-Kellner et al., Design Patterns for Securing LLM Agents against Prompt Injections, 2025: arxiv.org
- Invariant Labs, Tool Poisoning Attacks auf MCP, April 2025: invariantlabs.ai
- Linux Foundation, Agentic AI Foundation und MCP, Dezember 2025: linuxfoundation.org
- Stripe, Idempotent requests: docs.stripe.com
- AI Act, Art. 14: artificialintelligenceact.eu; DSGVO, Art. 22: dsgvo-gesetz.de
- Haystack (deepset), Agent-Komponente: docs.haystack.deepset.ai
Über den Autor
Ich bin Florian Rocktäschel, Ingenieur (RWTH Aachen). Ich arbeite seit 2013 mit lernenden Verfahren und seit 2018 als Fractional CTO für mittelständische Unternehmen. Hier schreibe ich auf, was ich in dieser Arbeit immer wieder gefragt werde.
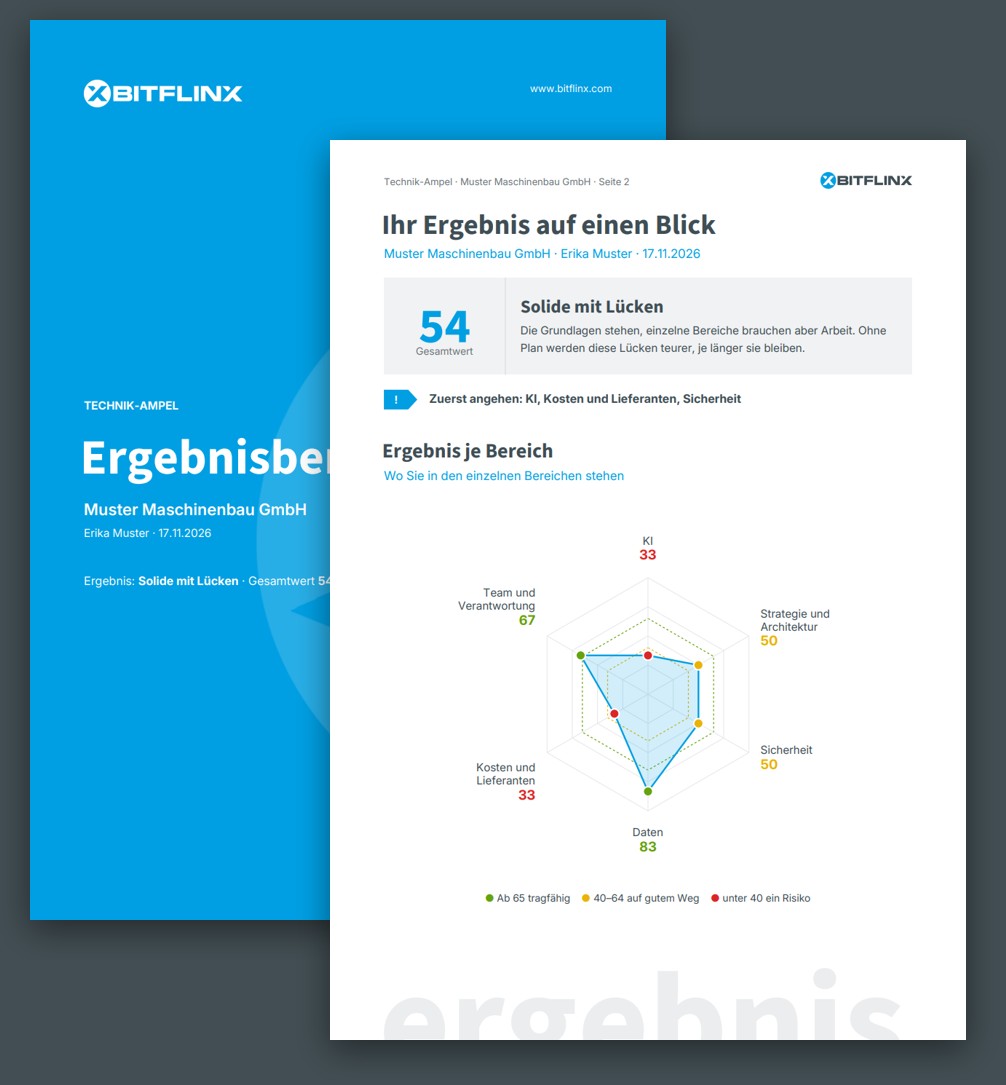
Wo steht Ihre Technik?
Die Technik-Ampel fragt in 15 Fragen nach KI, Strategie, Sicherheit, Daten, Kosten und Team. Zehn Minuten, Ergebnis sofort, kostenlos.